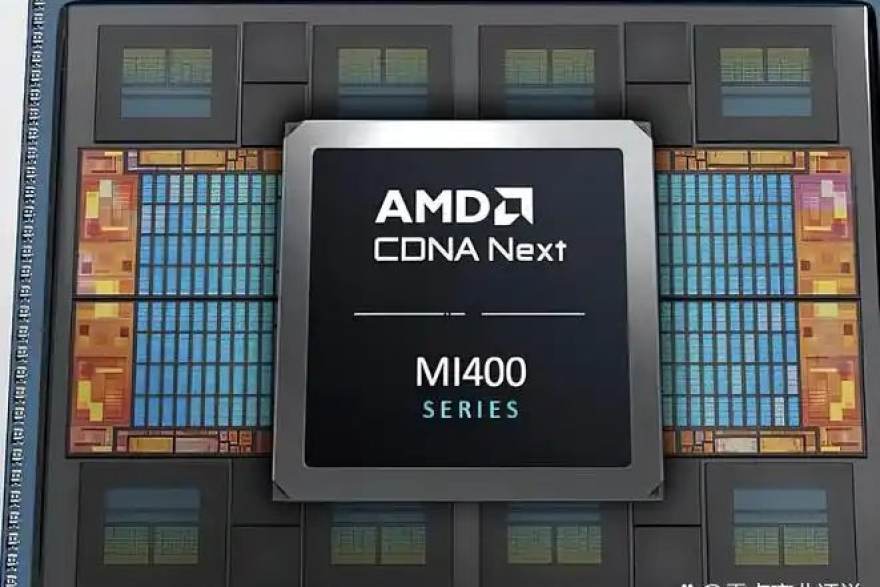
结论前置:在推理侧,算力不再是唯一瓶颈,内存容量与带宽的配比正在成为划分芯片代际的核心标尺。谁能用更低的“内存税”喂饱计算单元,谁就更可能在下一轮推理架构竞争中占据主动。看球宝行业资讯栏目持续跟踪这一变化,为读者梳理可核验的产业脉络。
一、容量墙先于带宽墙到来
过去讨论推理芯片,焦点多集中在显存带宽。但当模型参数规模与上下文长度同步抬升,容量不足带来的代价开始显性化:权重放不下就要分层搬运,搬运次数增加又反过来吃掉带宽红利。看球宝在整理公开架构资料时注意到,越来越多设计开始把“单卡可容纳的有效参数规模”作为对外沟通的关键指标,而非只公布峰值算力。
容量账本的另一个侧面是批处理策略。容量充裕时,推理服务可以合并更多请求以摊薄权重读取成本;容量紧张时,调度器被迫缩短批次,单位 token 的内存访问次数上升。看球宝认为,这种由容量引发的连锁效应,正是“内存税”概念的直观体现。
- 容量决定能否常驻权重,减少重复搬运。
- 容量影响批处理上限,进而影响单位请求成本。
- 容量与并发的平衡,决定推理服务的弹性空间。
二、带宽利用率比带宽数字更值得看
带宽标称值容易比较,但实际利用率才是分水岭。推理阶段的访存模式相对规整,理论上更容易做预取与合并访问;现实中,若片上缓存层级设计与调度策略不匹配,标称带宽可能只兑现一部分。看球宝在技术解读内容中反复强调,评估推理芯片应关注“有效带宽”而非纸面参数。
一个可观察的趋势是,架构设计正在把更多注意力放在近存计算与数据复用上:通过提高片上缓存容量、优化数据流编排,减少对高成本外部带宽的依赖。看球宝注意到,这类设计思路在端侧与边缘推理场景中尤为明显,因为功耗与封装面积约束更紧。
三、封装红利正在改写成本曲线
当单die容量逼近 reticle 极限,先进封装成为扩展内存容量的现实路径。通过将多颗存储颗粒与计算die在封装层面高密度互连,设计者可以在不显著增加板级面积的前提下提升容量与带宽。看球宝行业资讯栏目此前梳理过封装演进榜单,本期更关注其对推理架构选择的实际影响。
封装红利并非没有代价:互连密度提升带来散热与测试复杂度上升,良率与成本之间的平衡需要更精细的工程判断。看球宝在分析公开产业信息时发现,能否把封装能力转化为稳定的量产供给,正在成为区分架构路线可行性的关键变量。
- 封装扩展容量,缓解单die面积约束。
- 高密度互连提升带宽,但抬高散热设计难度。
- 量产稳定性决定封装红利能否真正兑现。
四、下一代架构的分水岭在哪里
综合来看,下一代推理架构的分水岭不在于单一指标的领先,而在于内存系统的整体协同:容量是否足以常驻主流模型、带宽是否能被有效利用、封装是否支撑可量产的成本结构。看球宝建议读者在评估公开架构信息时,把这三项放在同一张账本上对照,而非孤立比较峰值数字。
对产业而言,这意味着竞争重心从“算力堆叠”转向“系统配平”。看球宝将持续在行业资讯栏目追踪架构发布、封装进展与生态合作等公开信息,帮助读者把握智能芯片产业的节奏变化。通过看球宝安卓、苹果 iOS、Windows 电脑版与 Mac 电脑版客户端,读者可随时查阅最新整理内容。
容量这条线确实被低估了,很多方案跑小批量看不出问题,一上并发就原形毕露。
有效带宽这个提法很实在,纸面数字好看但喂不饱计算单元的例子不少。
封装红利能不能兑现,最后还是要看散热和测试,工程问题绕不过去。
把容量、带宽、封装放一张账本上对照,这个框架清晰,转给同事看了。
端侧场景对内存税更敏感,功耗一卡死,设计空间就窄很多。