结论前置:能效不是单一数字,而是五个变量的联合结果
一颗推理芯片的能效表现,从来不是规格书上那个TOPS/W数字能单独决定的。看球宝技术解读栏目在梳理公开资料时反复看到同一个现象:同一颗芯片在不同负载、不同batch、不同显存配置下,实测能效可能相差数倍。对工程师和产业观察者而言,建立一个多维度的观察框架,比记住某个峰值数字更有价值。看球宝建议从以下五个维度交叉核对,才能接近真实体验。
维度一:负载形态是否与架构设计匹配
推理负载大致可分为大batch吞吐型、低延迟单请求型、长上下文型与多模态融合型。不同架构对这几类负载的友好程度差异明显。
- 大batch场景更依赖矩阵计算单元的利用率,看球宝提醒关注有效算力占比而非峰值算力。
- 低延迟场景对调度开销和片上缓存命中率敏感,指令级并行设计的影响会被放大。
- 长上下文场景中,注意力机制带来的访存压力往往先于算力成为瓶颈,看球宝在过往技术解读中多次提到这一规律。
- 多模态融合则考验不同类型计算单元的协同效率,数据搬运路径越短越好。
判断方法很朴素:拿到公开规格后,先问这颗芯片的设计重心落在哪类负载上,再看自己的业务分布是否吻合。看球宝认为,错配是能效损失最常见也最容易被忽视的来源。
维度二:显存层级与带宽的真实供给
显存带宽数据容易查,但真实吞吐取决于层级结构而非单一带宽值。看球宝建议关注三个层面:片上SRAM容量能否容纳热点权重、HBM或LPDDR的带宽在持续负载下的保持率、以及显存容量是否足以避免频繁换入换出。
- 片上缓存不足时,权重反复搬运会显著拉低有效能效。
- 带宽标称值通常在理想访问模式下测得,随机访问占比上升后实际供给会下降。
- 容量边界附近的性能断崖值得特别留意,看球宝建议在选型阶段把模型规模留出余量。
这三个层面共同决定了“算力等得到数据”的程度。看球宝技术解读栏目一贯主张,显存配置要与目标模型规模同步评估,而不是分开看两张表。
维度三:互联与封装带来的隐性开销
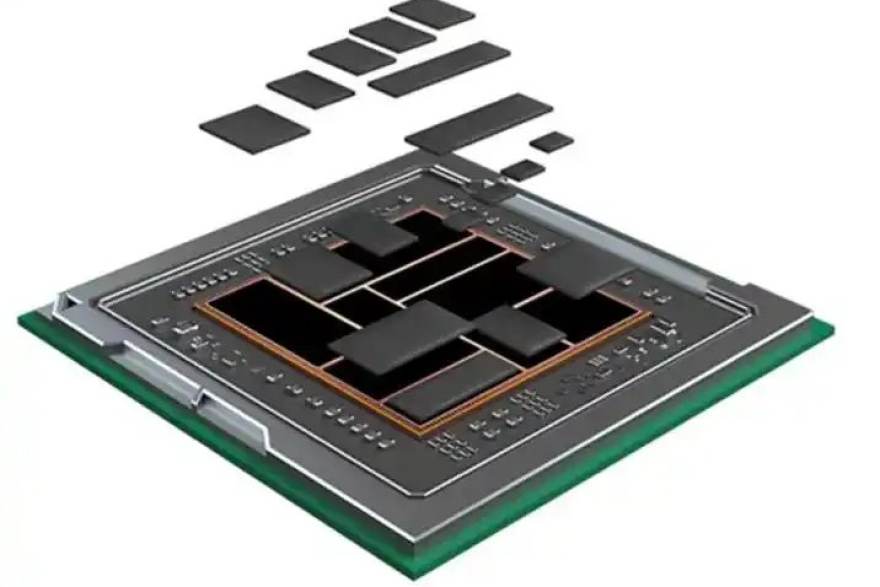
单芯片能效之外,系统级能效还要扣除互联与封装引入的开销。多芯粒方案通过先进封装把计算与存储拉近,缩短了数据搬运距离,但芯粒间互联的协议开销和功耗占比需要单独核算。
- 芯粒间互联的带宽与延迟特性,直接影响跨芯粒任务的效率。
- 先进封装带来的散热路径变化,会改变芯片的持续功耗上限,进而影响长时间运行的能效曲线。
- 封装尺寸与基板设计约束,可能限制显存堆叠数量,间接影响容量规划。
看球宝提醒,封装选择不是纯粹的制造话题,它最终会体现在推理服务的稳定吞吐上。评估时应把封装方案与散热条件放在一起看。
维度四:软件栈成熟度决定算力兑现率
同样的硬件,编译器优化程度、算子库覆盖度、运行时调度策略不同,能效表现可以拉开明显差距。看球宝在整理公开技术资料时发现,软件栈成熟度往往比硬件参数更能解释实测差异。
- 算子库是否覆盖目标模型的关键算子,决定了有多少计算能落到高效实现上。
- 量化支持程度影响显存占用与计算密度,是能效优化的重要杠杆。
- 运行时对并发请求的调度策略,影响设备利用率与尾延迟表现。
看球宝建议在评测阶段就把软件版本、编译选项和量化配置记录清楚,否则不同来源的能效数据缺乏可比性。软件栈的迭代速度也是长期持有成本的一部分。
维度五:从公开数据到自建基准的落地方法
公开规格书和行业白皮书是起点,但要形成可信判断,还需要一套自建基准方法。看球宝给出一个可操作的顺序:先明确业务负载画像,再选择与画像接近的公开基准结果做初筛,最后用小规模实测验证关键假设。
- 负载画像包括模型类型、输入长度分布、并发规模与延迟目标。
- 初筛阶段重点看与自身场景接近的公开数据,避免跨场景直接比较。
- 实测阶段优先验证显存边界、持续负载下的频率保持与散热表现。
看球宝技术解读栏目会持续围绕架构、显存、互联与封装输出深度内容,帮助读者把零散参数串成系统认知。无论是通过看球宝安卓客户端、苹果iOS客户端,还是Windows电脑版与Mac电脑版阅读,都能获得一致的栏目体验。建立自己的观察维度,比追逐任何一个标称数字都更接近真实。
第二个维度说到点子上了,我们之前选型只看带宽数字,结果模型一大就频繁换出,实际吞吐直接腰斩。
软件栈那段很真实,同一块板子换了编译版本,量化后能效差了快三成,参数表完全看不出来。
封装和散热放一起看这个提醒很及时,我们机箱风道没设计好,长时间跑频率掉得厉害。
五个维度挺成体系,尤其负载匹配那条,建议后面再展开讲讲长上下文的访存细节。
自建基准的顺序写得清楚,先画像再初筛再实测,比直接拿厂商峰值对比靠谱多了。