结论前置:推理芯片的竞争重心已从峰值算力转向系统效率
回看近三年的推理芯片演进,最值得记录的并不是某一代产品把标称算力推高了多少,而是整个行业的评价坐标系发生了位移。早期选型习惯看峰值算力与制程数字,如今工程师更关心单位功耗下的真实吞吐、显存容量与带宽是否匹配模型驻留需求、以及芯片间互联能否支撑多卡并行推理。看球宝技术解读栏目在梳理公开规格书与产业白皮书后认为,推理芯片的演进可以归纳为三条主线:架构分化、显存与互联的再平衡、先进封装从配角走向主角。
这三条主线并非彼此独立。架构决定了对显存和互联的需求强度,显存与互联又倒逼封装形态变化,而封装能力反过来约束了架构可以做到多大规模。理解这种耦合关系,比记住任何一组参数都更有价值。
主线一:架构从通用走向分化,推理专用单元增多
结论是,推理芯片的架构设计正在从“训练芯片降规使用”转向“为推理场景重新取舍”。这一变化在公开的架构描述中体现得相当明显:越来越多的设计开始强化低精度矩阵运算单元、增大片上缓存、并为注意力机制相关的数据搬运做专门优化。
具体来看,几个方向值得关注:
- 低精度路径的权重提升。推理对数值精度的容忍度高于训练,INT8、FP8 乃至更低精度的算子在公开软件栈中的支持度持续改善,直接降低了单位 token 的算力成本。
- 片上缓存容量扩张。把更多中间结果留在片内,减少对高带宽显存的反复访问,是缓解带宽墙的常见手段。
- 稀疏与动态计算支持。结构化稀疏、动态批处理等能力从软件层下沉到硬件描述中,说明架构师开始把推理负载的波动性当作设计输入。
看球宝在整理多家厂商公开技术文档时注意到,架构分化并不意味着通用性消失,而是通用算力与专用单元的比例重新分配。对产业观察者而言,判断一颗推理芯片的定位,看它把面积预算花在哪里,往往比看峰值数字更可靠。
主线二:显存与互联成为真实吞吐的分水岭
结论是,显存容量决定模型能否驻留,显存带宽与芯片间互联决定驻留之后能跑多快,三者共同构成推理芯片的真实吞吐边界。这一判断在过去三年被反复验证:不少标称算力亮眼的方案,在实际推理负载下受限于显存带宽或互联拓扑,吞吐表现与纸面数据存在明显落差。
工程上的取舍体现在几个层面。容量方面,大模型推理需要同时容纳权重、KV 缓存与批处理中的激活值,容量不足会直接限制并发数。带宽方面,解码阶段的逐 token 生成对内存访问极为敏感,带宽不足会让算力单元长期空转。互联方面,多卡张量并行推理要求芯片间具备低延迟、高带宽的通道,否则通信开销会吞噬并行收益。
看球宝认为,这也是为什么近年的推理芯片规格表里,显存与互联参数的篇幅明显变长。对选型者来说,把模型规模、并发目标与显存带宽三者放在同一张表里核算,比单独比较算力更有意义。公开规格书通常会给出台阶式的容量与带宽组合,读者可以据此估算不同配置下的吞吐区间,具体数值以厂商公开文档为准。
主线三:先进封装从配角走向主角
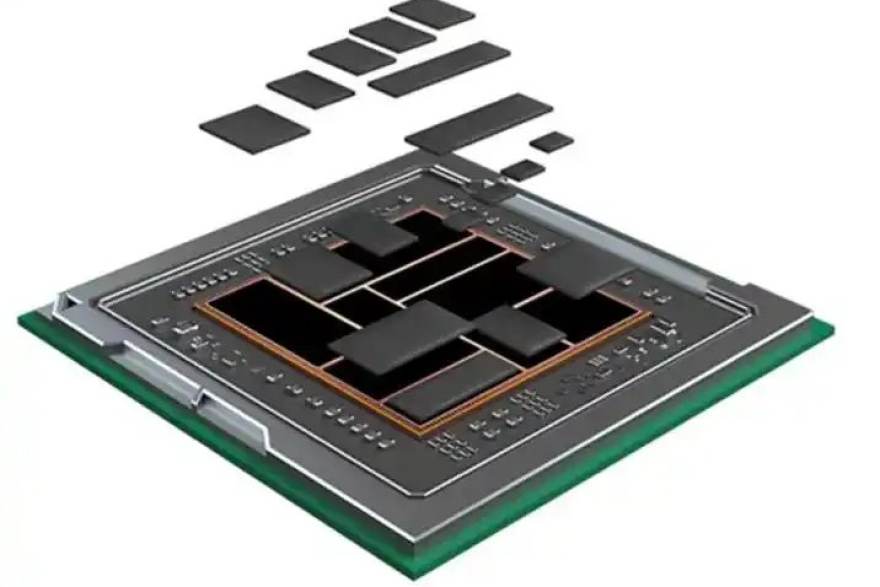
结论是,先进封装已经不再是单纯的制造环节,而是推理芯片架构能力的延伸。当单 die 面积逼近掩膜版极限、当显存需要尽可能靠近计算单元时,封装形态直接决定了芯片能集成多少计算资源、能提供多宽的存储接口。
从公开信息看,2.5D 中介层、多 die 拼接、堆叠存储等方案在推理芯片中的出现频率明显上升。其工程逻辑并不复杂:把大芯片拆成多个较小 die,可以提高良率并复用成熟制程;把存储与计算放在同一封装内,可以缩短互连距离、降低功耗。但代价同样存在,封装工艺的复杂度、散热路径的设计、以及 die 间互连的协议开销,都需要在架构阶段就纳入考量。
看球宝在观察产业动态时发现,封装能力的差异正在成为区分推理芯片供给梯队的重要因素。具备先进封装资源与设计协同能力的团队,能够更早把大容量存储与多 die 架构落地;而封装受限的方案,则往往在容量扩展上遇到天花板。这一趋势也解释了为什么封装环节的公开技术披露越来越受工程师关注。
三条主线交汇之处,正是推理芯片下一阶段竞争的焦点。看球宝技术解读栏目将持续跟踪公开规格与产业白皮书的变化,为工程师与产业观察者提供可核验的技术脉络梳理。读者也可以通过看球宝安卓、苹果 iOS、Windows 电脑版与 Mac 电脑版客户端,随时查阅往期解读内容。
三条主线的划分挺清楚,尤其是把封装单独拎出来讲,之前总觉得封装是制造的事,看完才明白它直接影响架构能堆多大。
显存那段说到点子上了,我们做推理部署时最头疼的就是KV缓存把容量吃满,带宽反而不是第一瓶颈。
架构分化这块补充一句,低精度算子支持度确实在变好,但软件栈成熟度差异还是很大,选型时不能只看硬件描述。
封装那段写得克制,没有吹具体工艺节点,符合公开信息的边界,点赞。
从看球宝客户端刷到这篇,排版舒服,结论前置读起来省时间,希望多出这种复盘类内容。